登录体验更流畅的互动沟通
更多待解决问题>>
国产模型为何被误判不行?
回答数
5
浏览数
5,808
思茵惠美
幻想比利
弗劳尔乃心
卡布卡萨
菲德闻珈
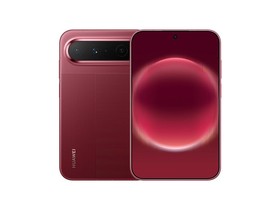
HUAWEI Pura X View 12GB+256GB 跃影红 华为阔直屏
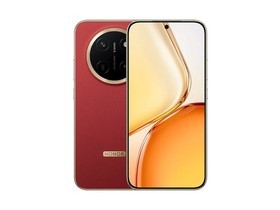
荣耀X80 Pro Max 8+128 闪电红【现货速发】11000mAh
vivo X300 12GB+256GB 幸运彩 蔡司2亿超级主摄 蔡司
Apple/苹果 iPhone 17 Pro Max 256GB 星宇橙色 支持
华为Pura X View(12...
荣耀X80 Pro Max(8G...
感谢您为社区的和谐贡献力量请选择举报类型
经过核实后将会做出处理感谢您为社区和谐做出贡献
扫码参与新品0元试用晒单、顶楼豪礼等你拿
确定要取消此次报名,退出该活动?
您确认删除吗?请选择删除原因